В экосистеме реактивных библиотек для JavaScript сложились два разных подхода к тестированию производительности:
- Синтетические графы с тривиальной нагрузкой (например, js-reactivity-benchmark - сьюты
kairo,dynamic,cellx,s). Внутри узлов выполняется простое сложение чисел, поэтому замеряются чистые накладные расходы самого ядра: создание узлов, переброска указателей в списках подписчиков и работа планировщика. В таких тестах закономерно лидируют минималистичные движки-примитивы вроде alien-signals и @preact/signals-core. - Графы с тяжёлыми вычислениями и пересозданием структур - классический пример по мотивам статьи Big State Managers Benchmark и репозитория github.com/b-on-g/collider. Здесь в нескольких узлах вызывается ресурсоёмкая функция
hard(), а промежуточный узел на каждый чих заново собирает массив объектов через.map().
На таком графе побеждает не тот движок, у которого быстрее цикл по указателям, а тот, который умеет не делать лишнюю работу: пропускать невостребованные ветки и гасить обновления при неизменном содержимом структур.
По следам разбора PR #1 в $bog_collider мы собрали автономный воспроизводимый стенд github.com/pravosleva/mol-collider-benchmark, чтобы сравнить в одинаковых условиях среды Node.js 10 решений - от эталонных низкоуровневых примитивов до полнофункциональных стейт-менеджеров:
- @pravosleva/reactive-engine
- @vue/reactivity
- @angular/core (Signals)
- MobX
- $mol (mol_wire_lib)
- alien-signals
- @preact/signals-core
- Reatom (@reatom/core)
- SolidJS 2 (@solidjs/signals)
- Effector
Топология графа и две ловушки для реактивности
Граф состоит из двух входных сигналов (A, B), пяти вычисляемых узлов (C, D, E, F, G) и трёх побочных эффектов (H, I, J):
        ┌─────────┐               ┌─────────┐
        │ Signal A│               │ Signal B│
        └────┬────┘               └────┬────┘
             │ \                     / │
             │  \                   /  │
             │   ▼                 ▼   │
             │  ┌───────────────────┐  │
             │  │    Computed C     │  │
             │  │  (A % 2 + B % 2)  │  │
             │  └────┬─────────┬────┘  │
             │       │         │       │
             ▼       ▼         │       ▼
         ┌───────────────┐     │  ┌───────────────────────────┐
         │  Computed E   │     │  │        Computed D         │
         │ hard(C+A+D)│     │  │ map({ x: i + A%2 - B%2 }) │
         └───────┬───────┘     │  └──┬──────────┬──────────┬──┘
                 │             │     │          │          │
       (только если C == 0)    │     │          │          ▼
                 │             │     │          │  ┌───────────────┐
                 │             │     │          │  │  Computed F   │
                 │             │     │          │  │ hard(D||B) │
                 │             ▼     ▼          │  └───────┬───────┘
                 │      ┌──────────────────┐    │          │
                 └─────►│    Computed G    │◄───┼──────────┤
                        │ C+(C||E%2)+D+F│    │          │
                        └────┬────────┬────┘    │          │
                             │        │         │          │
                             ▼        ▼         │          ▼
                        ┌────────┐ ┌────────┐   │     ┌────────┐
                        │Effect H│ │Effect I│   │     │Effect J│
                        │hard(G) │ │  (G)   │   │     │hard(F) │
                        └────────┘ └────────┘   │     └────────┘
В каждой итерации выполняются два синхронных батча:
- Шаг 1:
B = 1,A = 1 + i * 2 - Шаг 2:
A = 2 + i * 2,B = 2
Здесь заложены две архитектурные проверки:
Ленивое отсечение невостребованной ветки (
C E % 2): На первом шаге A и B нечётные, поэтомуC = 1 + 1 = 2(истинно). В выраженииC E % 2правая часть не вычисляется. Хотя узелEнапрямую зависит отAиD, его значение никому не нужно. Если движок откладывает вычисления до фактического чтения (Pull/Hybrid Push-Pull), он пропуститhard()в узлеE. Движки со статическим графом (вродеcombineв Effector) вынуждены пересчитыватьEна каждом шаге.Структурное гашение пересоздаваемых массивов (
D): УзелDвычисляется по формуле:numbers.map(i => ({ x: i + A%2 - B%2 }))- На старте (
A=0, B=0):0 - 0 = 0 - На шаге 1 (
A=1, B=1):1 - 1 = 0 - На шаге 2 (
A=2, B=2):2 - 2 = 0
- На старте (
На каждом шаге D возвращает новую ссылку на массив, но содержимое элементов { x } остаётся прежним. Без структурного компаратора узел F и эффект J будут перезапускаться вхолостую.
Теоретический минимум вызовов hard() за два шага составляет 3 вызова: H на первом шаге и E, H на втором.
Почему глубокий equals не стоит вшивать по умолчанию
В $mol структурное сравнение ($mol_compare_deep) встроено в каждый атом по умолчанию. В большинстве других движков (SolidJS, Preact Signals, Angular Signals, MobX, @pravosleva/reactive-engine) базовым сравнением остаётся быстрый Object.is, а глубокое сравнение подключается опционально.
Причина проста: рекурсивный обход объектов и массивов имеет свою цену. В сьютах с частыми обновлениями крупных списков или графов без пересоздания DTO встроенный deepEqual начинает тратить заметное процессорное время даже там, где ссылки не менялись или менялись намеренно.
Поэтому в @pravosleva/reactive-engine мы оставили Object.is в горячем пути по умолчанию (нулевые накладные расходы), но добавили опцию { equals } в computed и signal, а также экспортировали готовые хелперы shallowEqual и deepEqual (с защитой от циклических ссылок через WeakMap):
import { ReactiveEngine, deepEqual as equals } from '@pravosleva/reactive-engine'

const engine = new ReactiveEngine()
const A = engine.signal(0)
const B = engine.signal(0)

const C = engine.computed(() => (A.value % 2) + (B.value % 2))
const D = engine.computed(
  () => numbers.map((i) => ({ x: i + (A.value % 2) - (B.value % 2) })),
  { equals }
)
Устройство стенда mol-collider-benchmark
Чтобы исключить влияние браузерных расширений и ручных замеров, весь пайплайн в репозитории mol-collider-benchmark автоматизирован одной командой:
bash bench.shЧто произойдет:
- Прогрев V8 JIT: Перед замером каждый движок выполняет 500 прогревочных итераций. Это позволяет V8 перевести горячие функции в оптимизированный машинный код и стабилизировать скрытые классы.
- Серия из 3 прогонов (в результате которых будет получено
Best Time): Каждый движок прогоняется 3 раза по 5 000 двухшаговых итераций. В итоговую таблицу попадает минимальное время, что отсекает случайные фоновые прерывания планировщика ОС и троттлинг CPU. - Замер памяти
node --expose-gc👇- Alloc (B/iter) - объём временных аллокаций в куче V8 за одну итерацию до вызова сборщика мусора;
- Retained (B/iter) - остаточный прирост памяти в пересчёте на итерацию после принудительного двойного вызова
global.gc();
- Автогенерация артефактов: После прогона
run.mjsсохраняет сырой слепок в./results/last-benchmark.json, скриптgenerate-svg.mjsрендерит векторную диаграмму./results/last-benchmark.svg, аupdate-readme.mjsобновляет сводную таблицу вREADME.md.
Результаты замеров
Более подробно можно ознакомиться здесь: https://github.com/pravosleva/mol-collider-benchmark
Среда выполнения: Node.js v22.20.0 (linux x64), Intel Core i7-8550U @ 1.80GHz, 5 000 итераций × 3 прогона.
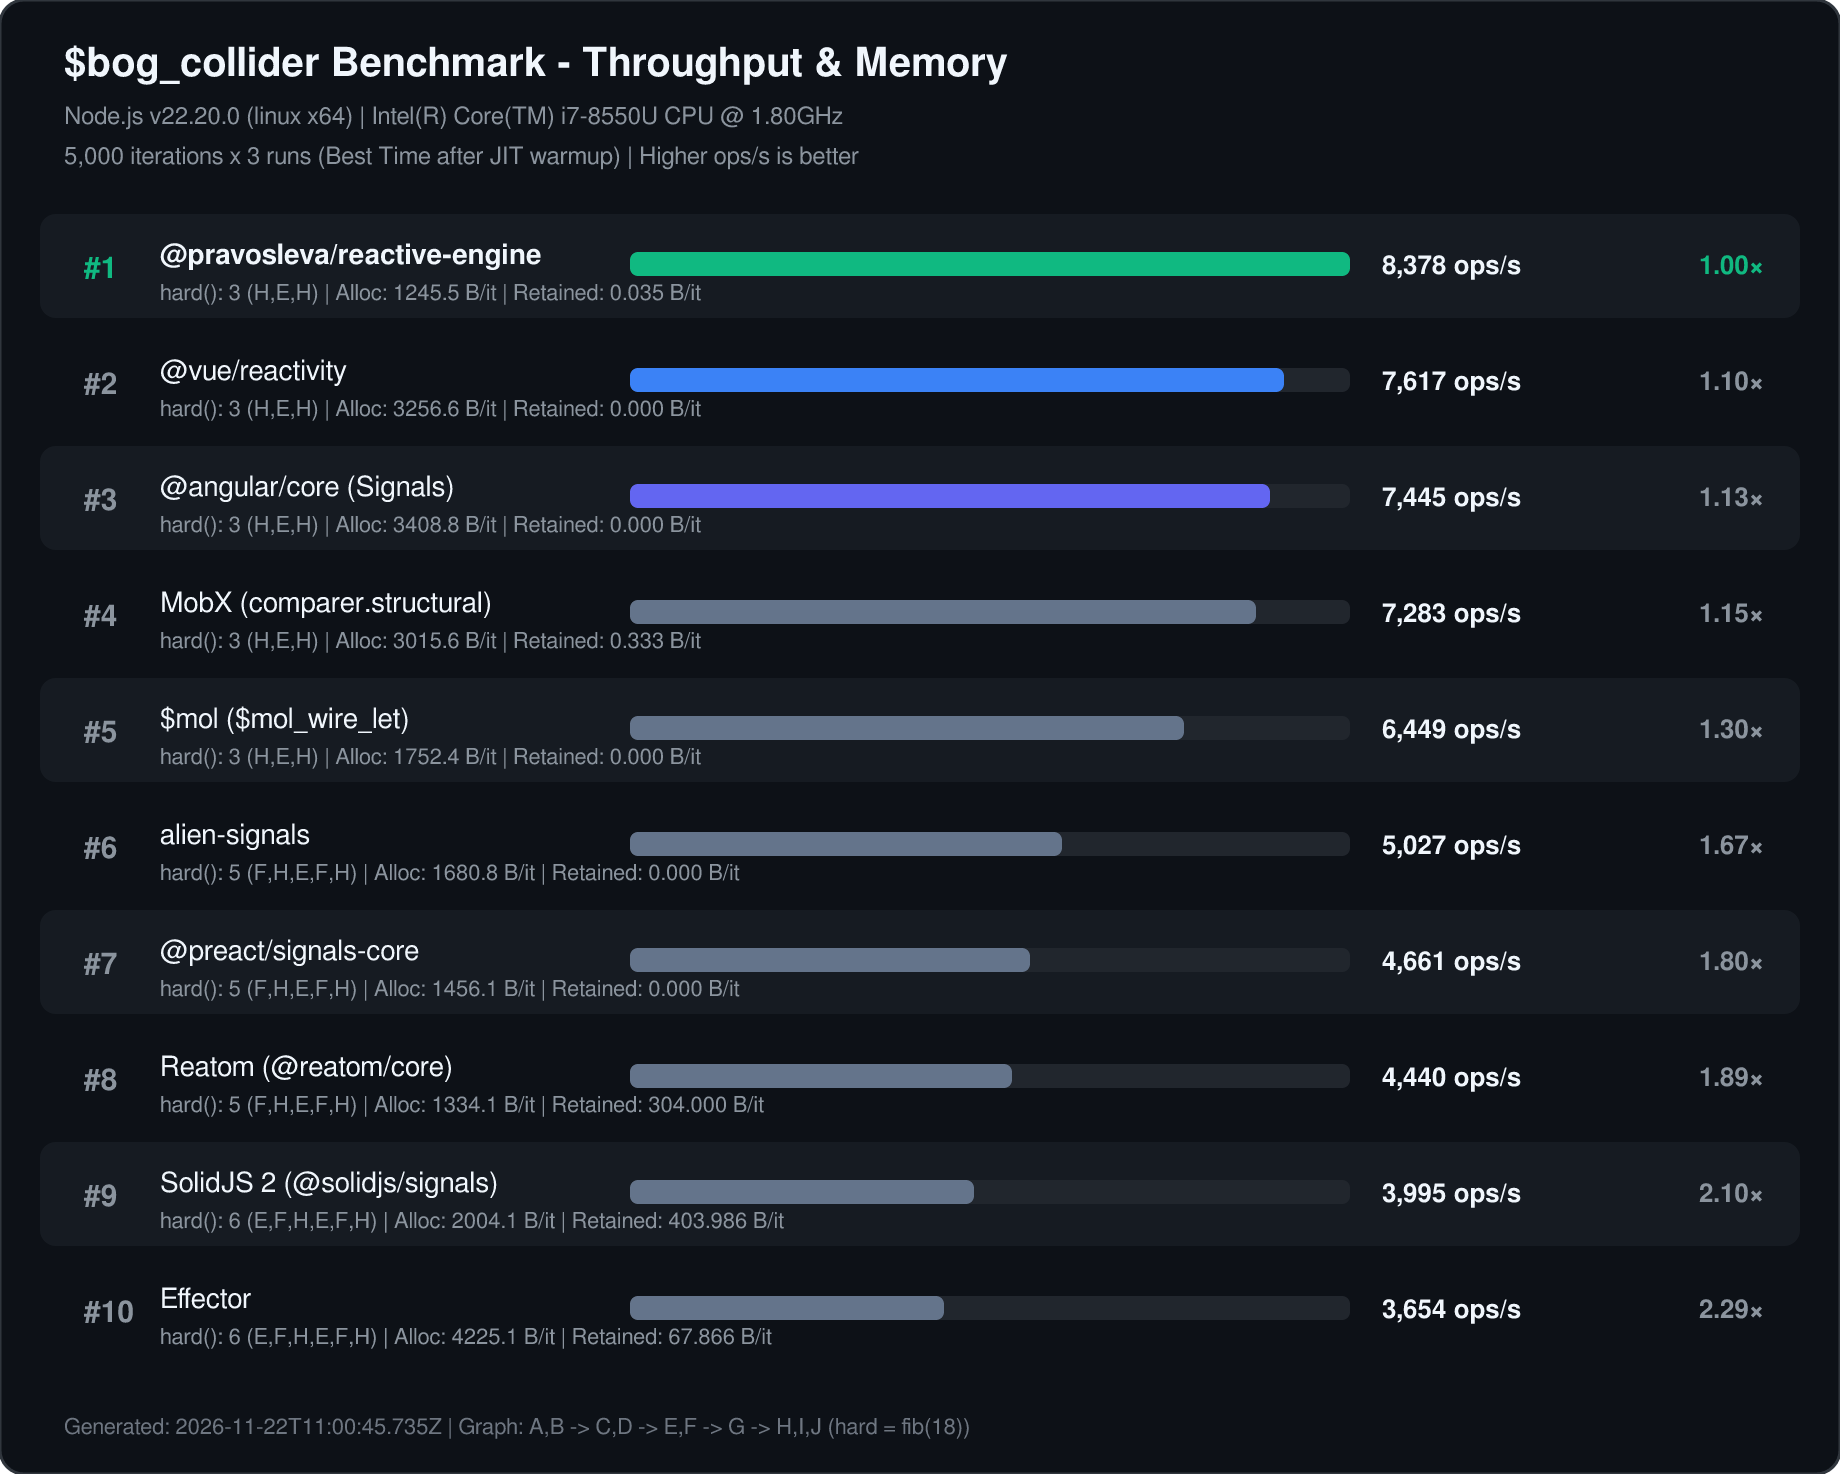
Поясняющие детали
hard() calls- количество и порядок вызововfib(18)за одну 2-шаговую итерацию. Теоретический минимум - 3 (H,E,H)Best Time (ms)- минимальное время выполнения 5 000 итераций из 3 прогонов после JIT-прогрева V8 (меньше — лучше);ops/sec- пропускная способность в полных двухшаговых итерациях в секунду (больше - лучше);Alloc (B/iter)- объём временных аллокаций в куче V8 за одну итерацию до сборки мусора (включает пересоздание массива из 5 объектов в узлеDи внутренние структуры планировщика движка);Ratio- отношениеBest Timeтекущего движка к лучшему результату в таблице (1.00×— лидер прогона).